通信世界网消息(CWW)9月21日,由北京市通信与互联网协会主办、工信智媒体中心协办的2026(第二十三届)北京互联网大会在京举办。中兴通讯CCN产品线国内MKT副总经理、规划总工冯建业以《开放协同,共赢Token经济时代》为题发表演讲,他表示,随着智能体、大模型快速迭代,算力评价逻辑已经发生根本性转变,行业不再单纯聚焦单芯片硬件参数,而是以端到端Token吞吐性能为核心,通过全栈开放与极致协同,实现算力资源最优TCO,支撑AI规模化落地。
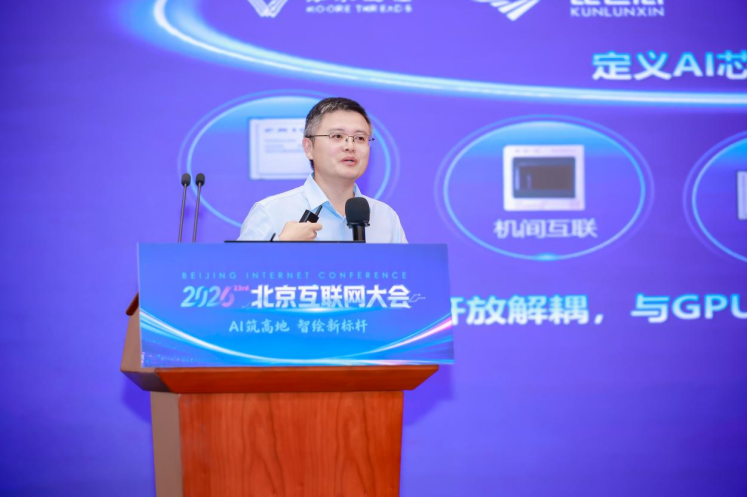
中兴通讯CCN产品线国内MKT副总经理、规划总工 冯建业
三大核心指标重构算力评价逻辑
自ChatGPT推出以来,行业对算力的关注点持续演变:早期重点关注芯片本身性能;训练与推理业务爆发后,算子适配、实际训练性能成为焦点。
进入Token经济阶段,算力评估逻辑迎来根本性变化。冯建业在演讲中谈到,
硬件指标、显卡数量不再是核心标尺,端到端Token吞吐效能才是衡量算力价值的关键,最终目标是实现最优TCO。
他提出Token经济下算力体系三大关键指标:每秒Tokens总吞吐量、单用户tokens吞吐、每瓦产出token数量。三者相互制约,算力池总吞吐高不代表单用户体验好,提升单用户吞吐往往会牺牲整体总吞吐;同时算力建设不能只看算力输出,功耗约束至关重要,芯片功率、整机功耗、散热方案必须统筹优化,才能产出低成本token服务。
此外,算力需求的多元化特征愈发凸显。冯建业特别提到,智能体驱动下,任务类型日趋复杂,场景需要大模型、超大模型与轻量化小模型协同工作。不同模型对硬件适配差异巨大,同一模型在不同芯片上优化效果差距明显,算力资源池必须支持多型号、多厂商芯片灵活选型,才能匹配模型需求,获得最优性价比。
“芯片架构也呈现多元发展态势,CPU、网络芯片、机内和机间互连芯片、各类加速芯片共同构成算力底座,GPU架构同样持续演进,算力基础设施需要面向多架构、多场景进行适配。”冯建业在演讲中
全栈开放软硬协同,首创OEX架构
想要实现算力最优效能,核心路径是全栈开放与极致协同,覆盖芯片、设备、网络、存储、软件全链条。
冯建业分享道:“在设备层面,算力向高密度服务器演进,单机GPU卡数量持续提升,以此拉高整体算力效能;高密度部署也倒逼机房在液冷、承重等基础设施方面升级,丰富算力形态选择。”
网络则成为释放芯片算力潜力的关键。记者了解到,中兴通讯首创了OEX正交无背板互联超节点架构,连续斩获行业重磅奖项,可兼容主流GPU芯片,通过超节点架构把异构芯片整合进统一算力体系。
而在存储侧的创新带来显著成本下降。冯建业进一步谈到,依托外置存储承载KVCache,可将缓存成本降至原有水平的1/10甚至1/100。而软硬协同优化的价值,甚至超过硬件本身。算子优化、模型适配、智能体调度、上下文压缩等软件工程手段,能够大幅减少Token消耗,部分场景下可降低90%乃至99%的Token成本,这需要大规模工程化投入。
冯建业最后总结道:“这套开放解耦的算力理念已经在运营商、头部互联网企业、电力等多个行业落地商用。未来,中兴通讯将持续联合产业伙伴,共建开放多元生态,持续优化Token整体TC0,赋能人工智能产业高质量发展。”